实时计算Flink版 数据处理服务的核心引擎
在当今数据驱动的时代,企业对数据处理的实时性要求日益提高。传统的批处理方式已难以满足秒级甚至毫秒级的业务决策需求,而实时计算引擎正是应对这一挑战的关键技术。Apache Flink 作为业界领先的流处理框架,以其高吞吐、低延迟、 exactly-once 语义等特性,成为构建实时数据处理服务的首选。实时计算 Flink 版作为一项完全托管的云服务,进一步降低了用户使用 Flink 的门槛,提供了一站式的数据处理解决方案。
一、核心概念与定位
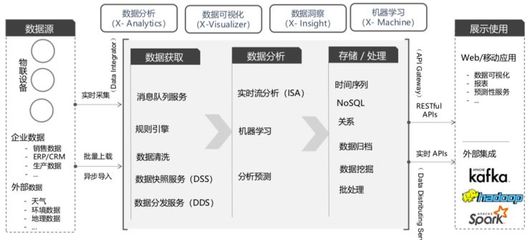
实时计算 Flink 版是一种全托管的实时数据处理服务,它基于开源 Apache Flink 构建,提供企业级特性,如自动伸缩、运维监控、SQL 开发界面等。其主要定位是帮助用户快速构建流式数据处理应用,无缝对接上下游数据源,实现数据的实时采集、处理、分析与输出。作为数据处理服务,它承担着实时 ETL、实时监控、实时风控、实时推荐等多样化场景的底层计算职责。
二、架构设计与关键特性
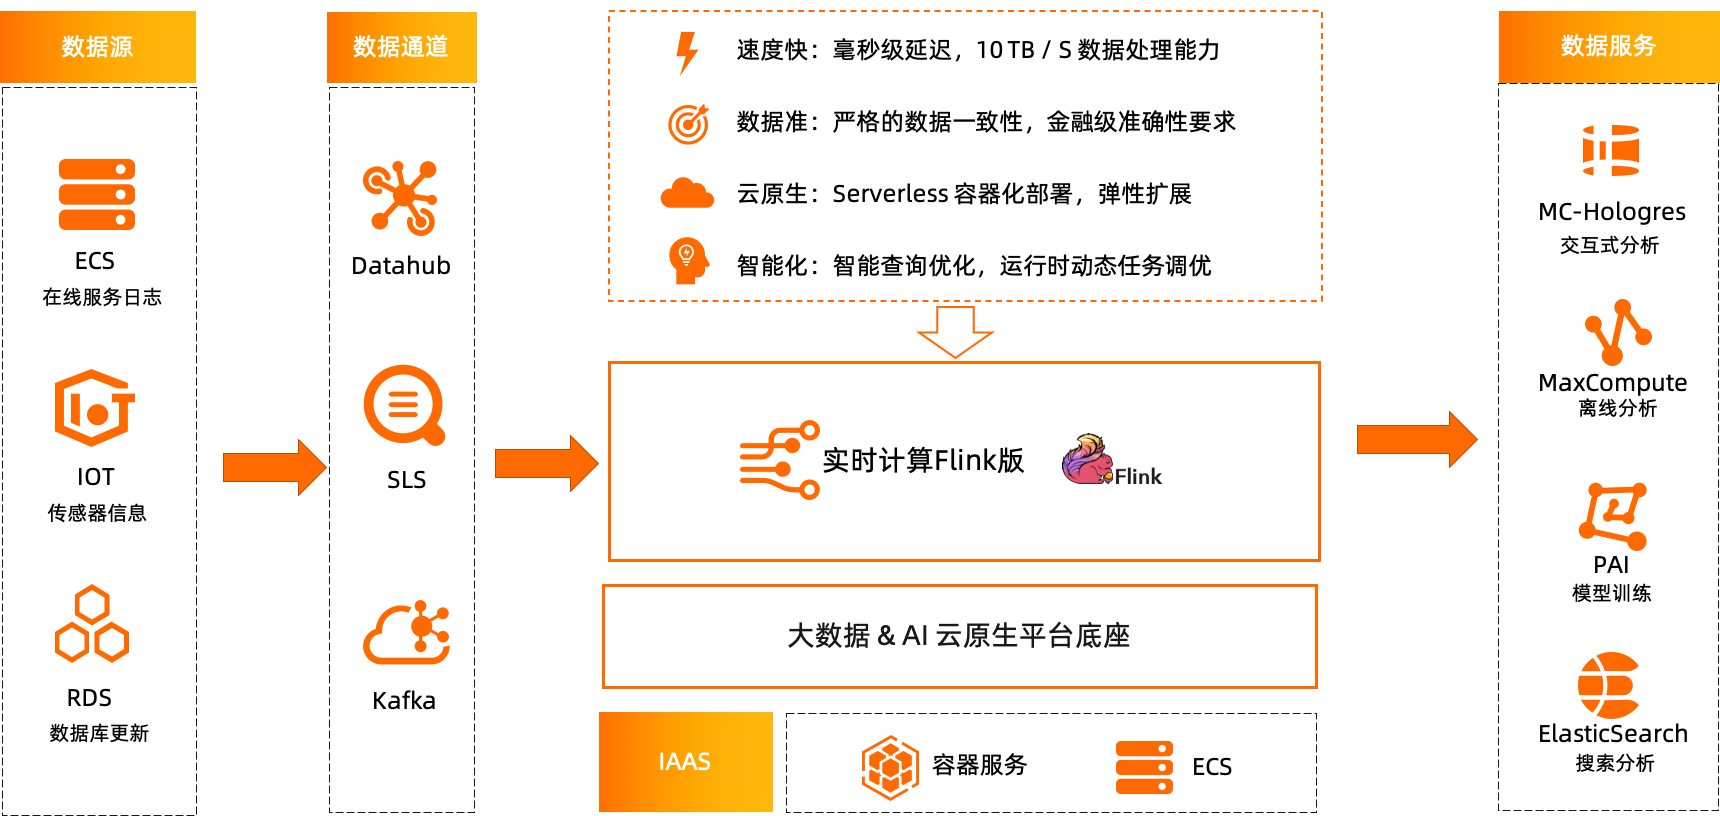
实时计算 Flink 版的架构通常包含管控层、计算层和存储层。管控层负责作业管理、资源调度和监控告警;计算层基于 Flink 集群执行作业;存储层则利用对象存储等持久化状态和数据。关键特性包括:
- 完全托管:用户无需关心集群部署、调优和故障恢复,只需专注业务逻辑。
- 实时SQL:支持标准的 Flink SQL 及扩展语法,通过 SQL 即可完成流式数据处理,降低开发门槛。
- 自动伸缩:根据作业负载动态调整计算资源,如基于 metrics 的自动扩缩容,优化成本与性能。
- 状态管理与容错:提供高效的状态后端(如 RocksDB)和检查点机制,保证 exactly-once 语义。
- 丰富的连接器:内置或支持大量数据源和数据汇的连接器,如 Kafka、MySQL、HBase、Elasticsearch 等,方便数据集成。
- 企业级安全:提供网络隔离、权限管理、数据加密等安全能力。
三、数据处理流程与用户操作
使用实时计算 Flink 版进行数据处理的典型流程为:
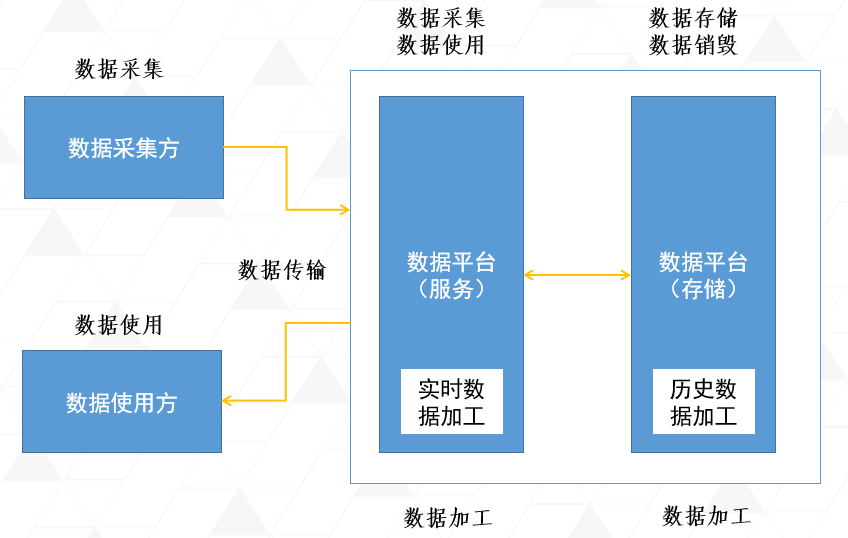
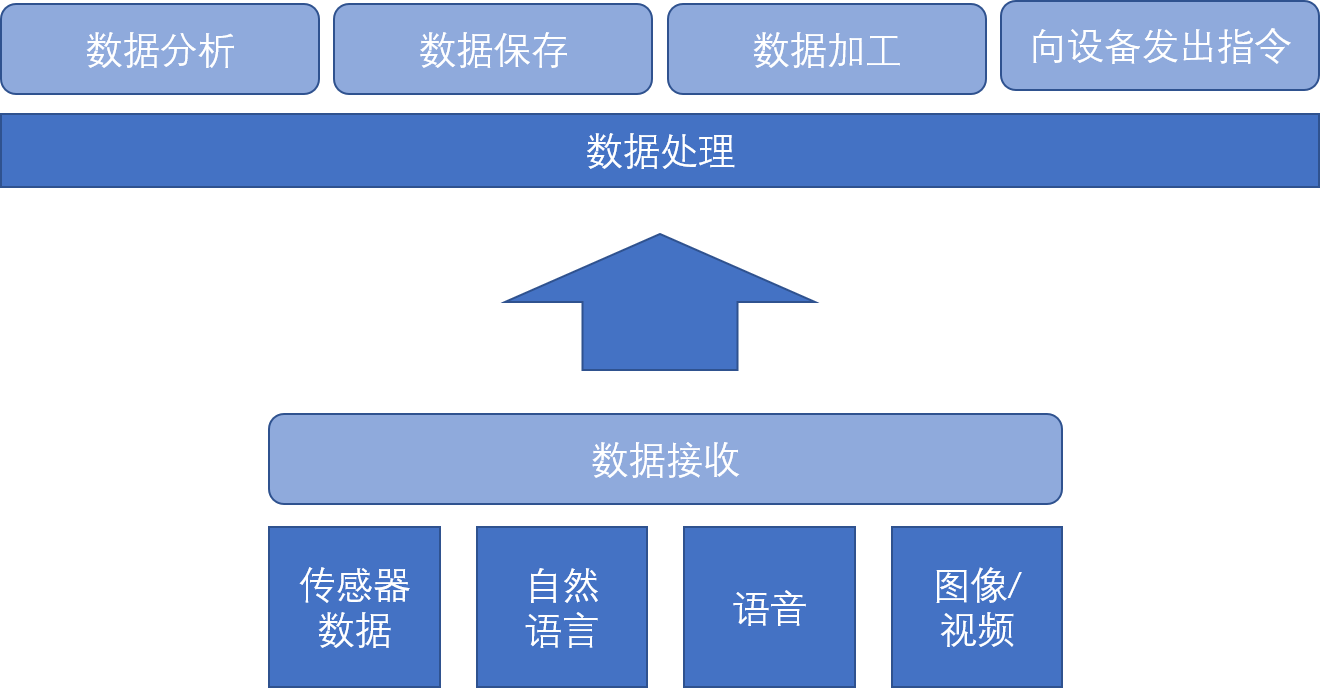
- 数据接入:通过连接器从消息队列或数据库中读取实时数据流。
- 数据加工:使用 SQL 或自定义代码对数据流进行过滤、转换、聚合、窗口计算等操作。
- 数据输出:将处理结果写入下游系统,供应用查询或进一步分析。
用户通过控制台或API开发并提交作业,服务负责作业的部署、运行和监控,并在异常时自动恢复。
四、典型应用场景
实时计算 Flink 版适用于需要低延迟数据处理的多种场景:
- 实时ETL:将数据从源系统清洗、转换后实时同步至数据仓库或数据湖。
- 实时监控与告警:对指标流进行实时聚合与规则匹配,及时触发告警。
- 实时风控:在交易、登录等场景中实时分析用户行为,识别欺诈风险。
- 实时推荐:基于用户实时行为动态更新推荐模型特征。
- 实时数据大屏:为可视化大屏提供乐数据处理服务,由于我无法获取完整信息。
- 物联网数据处理:对设备上传的遥测数据进行实时解析与状态监控。
五、与优势
实时计算 Flink 版作为一项数据处理服务,将强大的 Flink 流处理能力以云服务形式交付,具备弹性、安全、易用、低成本等优势。它使得企业可以聚焦业务创新,无需担心底层基础设施的运维复杂度,快速构建实时数据处理管道,赋能实时化业务决策。随着实时计算需求的增长,Flink 版将继续演进,提供更丰富的功能和更优的性能,成为企业实时数据战略的重要基石。
如若转载,请注明出处:http://www.53gpt.com/product/17.html
更新时间:2026-11-01 06:06:24