微服务架构下的数据处理方法与数据处理服务设计
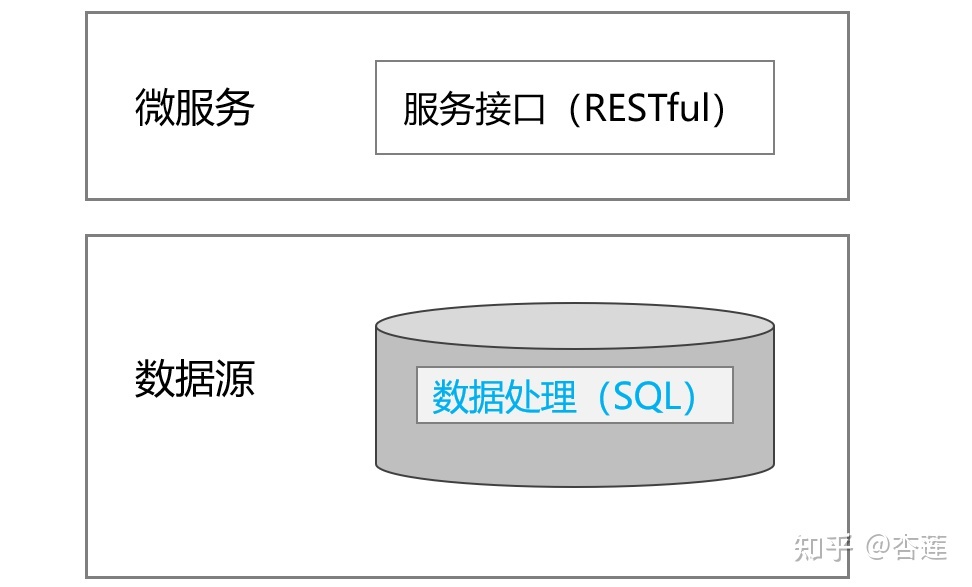
在微服务架构中,数据处理面临分布式、异构、高并发等挑战。合理的数据处理方法与专门的数据处理服务设计,是保障系统可扩展性、一致性与可靠性的关键。
一、微服务实施数据处理的核心方法
1. 数据库按服务私有化(Database per Service)
每个微服务拥有独立的数据库或Schema,仅通过API访问自身数据,避免跨服务直接访问数据库。服务间数据一致性通过事件驱动或Saga模式实现,而非分布式事务。
2. 事件驱动架构(EDA)
服务在数据变更时发布领域事件(如OrderCreated),其他服务订阅并异步处理。常用消息中间件包括Kafka、RabbitMQ、RocketMQ。事件需包含足够信息并保证至少一次投递,消费端需实现幂等。
3. CQRS与事件溯源
命令查询职责分离:写模型处理命令,读模型通过事件同步构建物化视图,适合读多写少、查询复杂的场景。事件溯源将状态变更持久化为事件序列,便于审计与回放,但需注意事件版本管理与快照。
4. Saga分布式事务
对于跨服务的长事务,采用编排(Orchestration)或协同(Choreography)式Saga,每个步骤定义补偿操作,确保最终一致性。
5. 数据集成与同步
通过变更数据捕获(CDC)工具(如Debezium)将数据库变更实时流入消息队列;或采用API组合、批处理ETL进行数据聚合。避免共享数据库模式,防止服务耦合。
二、数据处理服务的设计要点
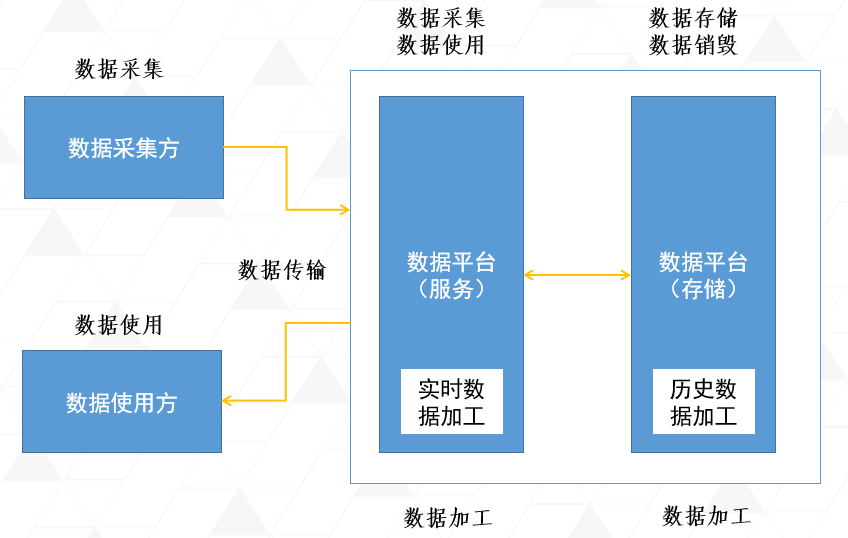
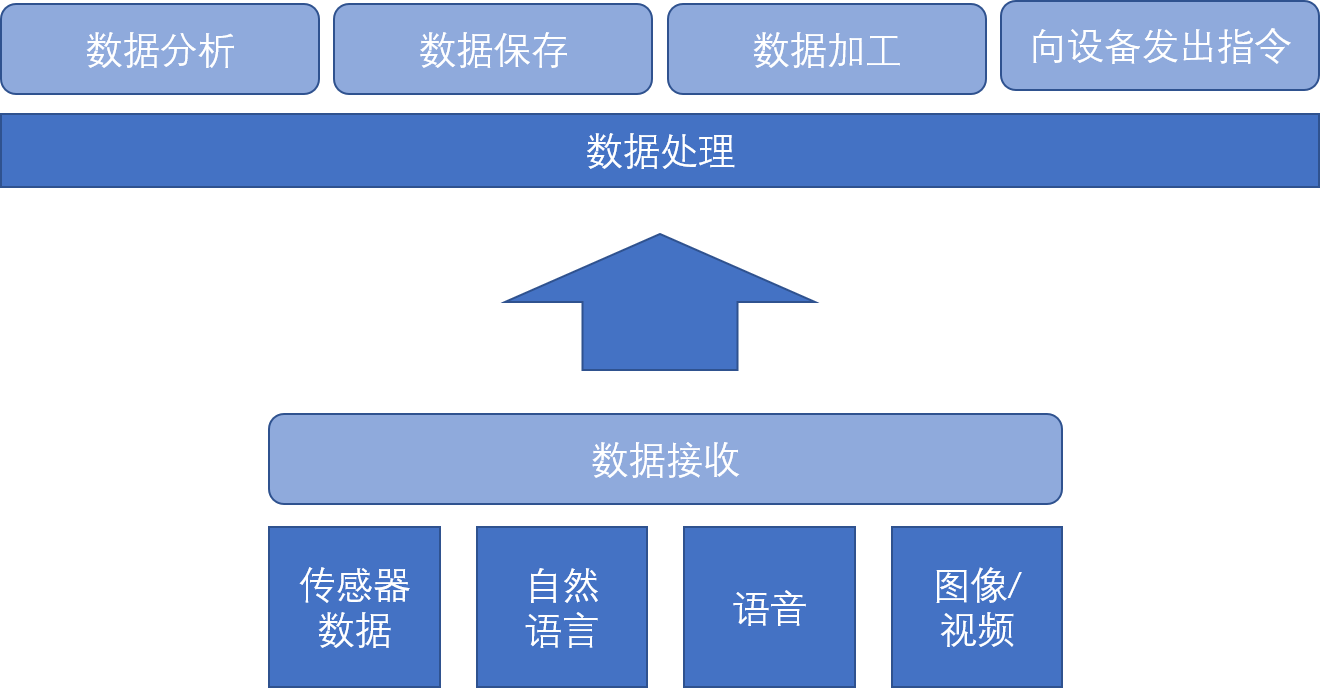
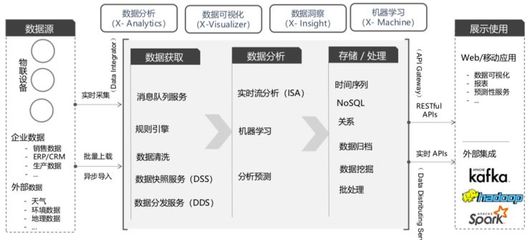
数据处理服务是专门负责数据采集、清洗、转换、聚合与分发的微服务。设计时需关注:
- 职责单一:明确输入输出契约,例如接收原始事件,输出标准化数据包。
- 无状态与弹性:服务实例无状态,通过消息队列缓冲流量,支持水平扩展。
- 幂等与容错:消费端基于业务ID去重,采用死信队列与重试策略处理失败。
- 可观测性:埋点指标(处理延迟、吞吐量、错误率)、分布式追踪与结构化日志。
- 数据质量:内置校验规则(模式校验、范围检查),异常数据分流至隔离区。
- 安全与合规:数据脱敏、加密传输、访问控制,遵循GDPR等法规。
三、典型处理流程示例
电商订单场景:订单服务创建订单后发布OrderCreated事件;数据处理服务消费事件,进行格式标准化、 enrich(补全用户画像)、聚合统计,并将结果写入分析数据库与搜索索引;同时触发库存服务与通知服务。该流程通过事件驱动解耦,数据处理服务作为中枢,保障数据一致性与实时性。
四、
微服务数据处理应坚持去中心化、异步优先、最终一致的原则。数据处理服务作为独立部署单元,需聚焦管道化处理能力,结合CDC、消息队列与流处理技术(如Kafka Streams、Flink),并强化幂等、监控与数据治理,从而构建健壮的数据流架构。
如若转载,请注明出处:http://www.53gpt.com/product/22.html
更新时间:2026-11-01 00:40:01