流式数据处理在数据工厂的应用 数据处理服务的实时化演进
在数字化转型的浪潮中,数据已成为企业的核心资产。传统的数据工厂主要依赖批处理模式,按照固定的时间窗口(如每日、每小时)对海量数据进行加工。随着物联网、金融风控、实时推荐等业务场景的爆发式增长,企业对数据处理的实时性提出了更高要求。流式数据处理作为一种新兴的数据处理范式,正逐步融入数据工厂的架构,成为数据处理服务向实时化、智能化演进的关键驱动力。
一、流式数据处理的核心特征
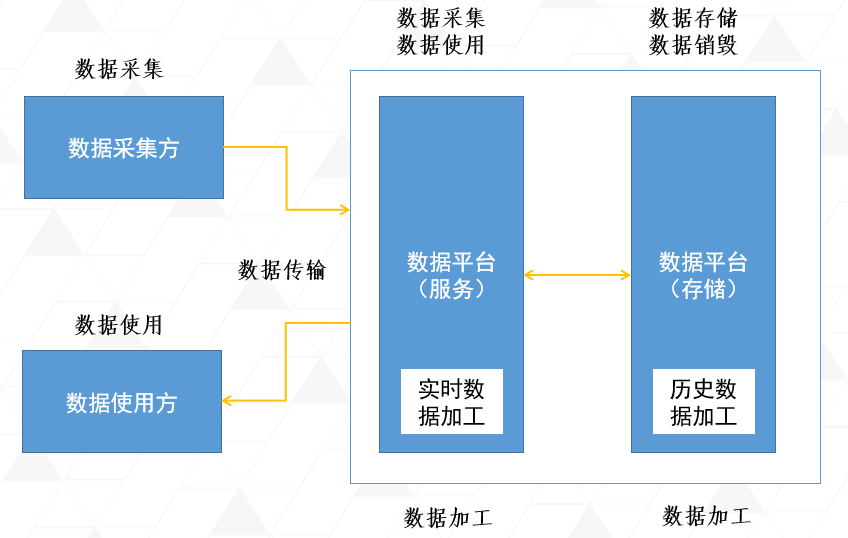
流式数据处理是指对持续不断产生的数据流进行实时采集、传输、计算和输出的过程。与批处理不同,流式处理强调低延迟(通常在毫秒到秒级)、持续计算和事件驱动。其技术栈通常包括消息队列(如Kafka)、流计算引擎(如Flink、Spark Streaming)和实时存储(如ClickHouse、HBase)。这些组件共同构成了数据工厂中实时数据处理服务的基础设施。
二、流式数据在数据工厂中的典型应用场景
1. 实时数据集成
数据工厂通常需要从多个业务系统抽取数据。流式处理能够实现变更数据捕获(CDC),将数据库的增量变更实时同步到数据仓库或数据湖,避免批量抽取带来的延迟和系统压力。这种实时集成服务确保了数据工厂中数据的时效性,为下游分析提供最新视图。
2. 实时ETL与数据清洗
在数据工厂中,原始数据往往存在噪声、缺失或格式不一致等问题。流式计算引擎可以在数据流动过程中执行过滤、映射、聚合等操作,实现实时ETL。例如,在金融交易场景中,流处理服务能够实时校验交易报文、识别异常交易并触发告警,大幅提升数据质量与风控效率。
3. 实时指标计算与监控
数据工厂需要为业务提供实时指标(如分钟级GMV、实时在线用户数)。通过流式处理,可以持续计算滑动窗口内的聚合指标,并将结果写入实时数据库或缓存,供仪表盘和监控系统调用。这种实时数据处理服务支撑了运营决策的敏捷性。
4. 事件驱动的数据服务
流式数据处理不仅用于分析,还可作为数据服务对外提供。例如,在推荐系统中,用户行为事件流经实时处理后,可即时更新用户画像并触发个性化推荐。数据工厂通过封装流式处理逻辑,形成可复用的实时数据服务API,供业务系统订阅调用。
三、流式数据处理服务在数据工厂中的架构实践
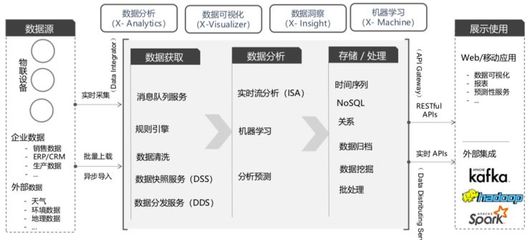
构建流式数据处理服务需要兼顾稳定性、可扩展性与易用性。典型架构包括:
- 数据接入层:通过Kafka等消息中间件统一接入多源数据流,实现削峰填谷与解耦。
- 计算层:采用Flink等流计算引擎,支持Exactly-Once语义和状态管理,保障计算准确性。
- 存储层:根据场景选择实时数仓(如Doris)、NoSQL或时序数据库,满足高并发读写需求。
- 服务层:将流处理结果封装为RESTful API或消息订阅服务,降低业务使用门槛。
数据工厂需建立完善的监控告警、资源隔离和容错机制,确保流式服务的SLA。
四、挑战与未来展望
尽管流式数据处理优势显著,但在数据工厂落地仍面临挑战:流式SQL的复杂性、状态管理的运维成本、以及批流一体化的技术融合。随着Serverless流计算和智能调优技术的发展,流式数据处理服务将更加普惠,成为数据工厂的标准能力。批流一体架构将统一数据处理逻辑,降低开发运维负担,使数据工厂能够同时满足海量离线分析与实时智能决策的需求。
流式数据处理正在重塑数据工厂的数据处理服务模式。通过构建实时化、服务化的流处理能力,企业能够更快地释放数据价值,在瞬息万变的市场中赢得先机。
如若转载,请注明出处:http://www.53gpt.com/product/26.html
更新时间:2026-11-01 06:22:38